robots.txt だけでは分からない:自分のサイトが AI ボットに返す応答を curl で確かめる
AI ボット一覧(レジストリ) > 自分のサイトで確かめる
robots.txt に GPTBot を許可と書いてあっても、レンタルサーバー、CDN、セキュリティ系プラグインが、書いていない理由で AI ボットに 403 を返していることがあります。サイトの持ち主は気づきにくい点です。curl が使える端末(Mac の「ターミナル」、Windows 10 以降のコマンドプロンプト)で、次の 3 つの層を順に確かめます。<自分のサイト> はあなたのドメインに置き換えてください。
自分のサイトだけで試す。他人のサイトに対して、ボットを名乗る確認リクエストを繰り返し送らないでください。
1. robots.txt に何と書いてあるか
まず、サイトが公開している意思表示を読みます。
curl -s https://<自分のサイト>/robots.txtUser-agent: GPTBot の下に Disallow: / があれば、そのボットには全体を拒否と書いてあります。何も出ない、404 が返る場合は、書いていない(ルールなし)という意味です。書き方の判定をそのまま見たいときは: AI ボットの robots.txt 確認(Parallel World)。
ここで分かるのは「書いてあること」だけです。サーバーが実際にどう応答するかは、次の層で見ます。
2. ボットの User-Agent で、サーバーが何を返すか
ボットが名乗る User-Agent を付けて、先頭ページのヘッダーだけ取ります(-I はヘッダーのみ、-A は User-Agent の指定)。6 つのボットの例です。User-Agent は運営会社が公開している文字列で、ボット名の token はレジストリ bots.json(CC BY 4.0)の 58 件と同じものです。
GPTBot(OpenAI)
curl -sI -A "Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko); compatible; GPTBot/1.4; +https://openai.com/gptbot" https://<自分のサイト>/OAI-SearchBot(OpenAI)
curl -sI -A "Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko); compatible; OAI-SearchBot/1.4; +https://openai.com/searchbot" https://<自分のサイト>/ChatGPT-User(OpenAI)
curl -sI -A "Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko); compatible; ChatGPT-User/1.0; +https://openai.com/bot" https://<自分のサイト>/ClaudeBot(Anthropic)
curl -sI -A "Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko; compatible; ClaudeBot/1.0; +claudebot@anthropic.com)" https://<自分のサイト>/PerplexityBot(Perplexity)
curl -sI -A "Mozilla/5.0 (compatible; PerplexityBot/1.0; +https://perplexity.ai/perplexitybot)" https://<自分のサイト>/Perplexity-User(Perplexity)
curl -sI -A "Mozilla/5.0 (compatible; Perplexity-User/1.0; +https://perplexity.ai/perplexity-user)" https://<自分のサイト>/比較の基準として、User-Agent を付けない通常の応答も取っておきます。
curl -sI https://<自分のサイト>/読み方
| 見る場所 | 意味 |
|---|---|
HTTP/2 200 | 応答が返った。この User-Agent は、この場所からは止められていない。 |
HTTP/2 403 | 拒否された。通常の curl が 200 で、ボットの User-Agent だけ 403 なら、User-Agent を見て止めている設定がある(サーバー、CDN、WAF、プラグインのどれか)。 |
HTTP/2 503、429 | 混雑、レート制限、またはボット向けの確認ページ。 |
server: | 応答した側の名前(例: cloudflare、AkamaiGHost、AmazonS3)。どこで止まったかの手がかり。 |
cf-mitigated: | Cloudflare が応答に介入した印。challenge ならボットに確認ページを返している。 |
あなたの IP から試した結果であって、運営会社の IP からの結果ではありません。200 だからといって、本物のボットが入れる証拠にはなりません。多くの CDN や WAF は、User-Agent と送信元 IP の組み合わせで判定するため、名乗りだけの curl は通り、本物の IP のボットは止まる(逆もある)ことがあります。403 のほうは、少なくとも User-Agent で止める設定があるという確かな手がかりです。HEAD リクエスト(-I)に別の応答をするサイトもあるので、気になるときは -I を外して試してください。
3. X-Robots-Tag:ページの本文ではなく、ヘッダーに書かれた指示
robots.txt とは別に、HTTP ヘッダー X-Robots-Tag でも、検索・AI への指示(noindex など)を出せます。2 の応答にそのまま含まれます。
curl -sI -A "Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko); compatible; GPTBot/1.4; +https://openai.com/gptbot" https://<自分のサイト>/ | grep -i x-robots-tag何も出なければ、そのヘッダーはありません。noindex や none が出たら、そのページは検索インデックスに載せない指示です。意図したものか確かめてください。ヘッダーは URL ごとに違えられるので、見たいページの URL でも試します。
4. ログに AI ボットの名前があったら、IP を確かめる
アクセスログに GPTBot や ClaudeBot の User-Agent があっても、名前は誰でも名乗れます。本物かどうかは、送信元 IP が運営会社の公開リストにあるかで確かめます。IP の確認: AI ボットの IP 確認(Parallel World)。リストの場所は AI ボット一覧 にまとめてあります。
私たちの数字
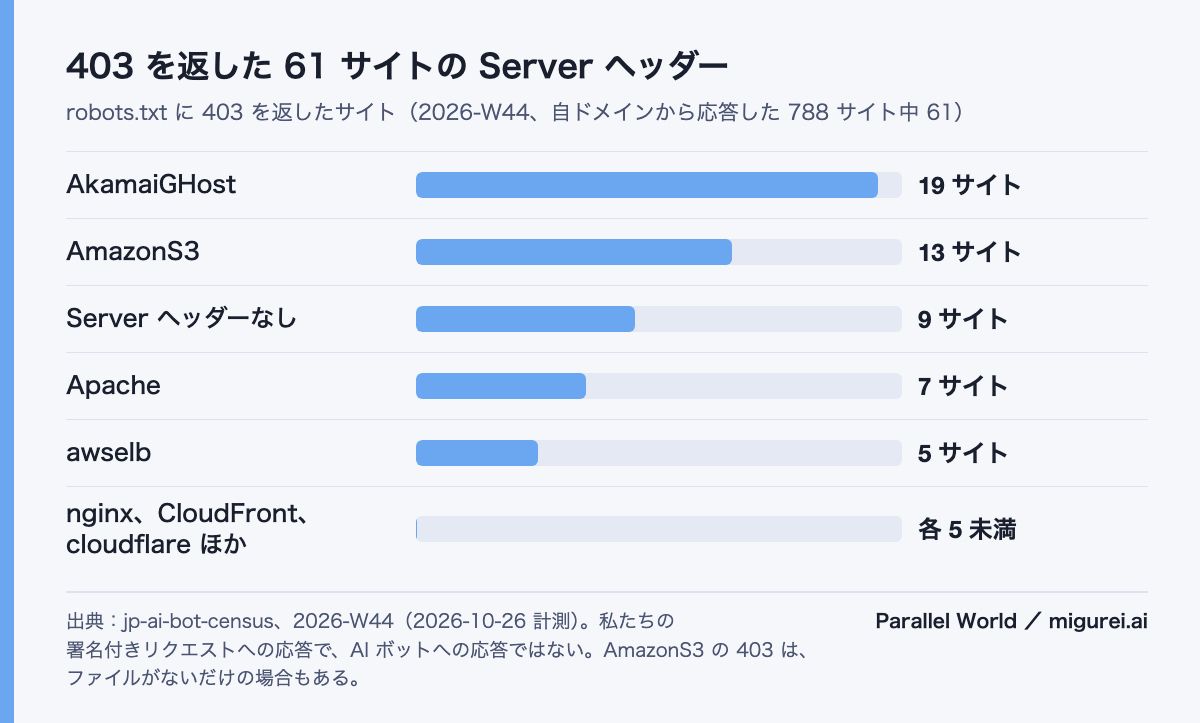
私たちの定点調査(2026年第44週、Tranco 上位の .jp サイト)では、788 サイト中 61 サイト(7.7%)が、私たちの署名付き robots.txt 取得リクエストに 403 を返しました(server は AkamaiGHost が 19、AmazonS3 が 13)。この 403 は私たちのリクエストへの応答で、AI ボットへの応答そのものではありません。ただ、robots.txt を読む前の段階で止まる設定が、実際に多くのサイトにあることを示しています。調査のデータ: .jp 上位サイトの AI ボット対応 週次定点調査。
出典
3 層で確かめるという考え方は、海外SEO情報ブログの記事(2026年10月28日)にあります: robots.txtだけでは分からない、GPTBotやClaudeBotなどAIクローラーのブロック状況を調べる診断ツール。そこで紹介されている診断ツールは英語です。本ページは、同じ確認を自分の端末で curl だけでやる手順です。
作成: Parallel World。レジストリ版 bots-2026-11-02、確認日 2026-11-02。