AI に「開いているか」だけでなく「適切に閉じているか」:測り方と当社の記録(2026年10月)
AI 向けにサイトを診断するツールは、どれも「どれだけ AI に開いているか」を測ります。Parallel World はそれに加えて、「適切に閉じているか」も測ります。このページは、その考え方と、これまでに当社が記録した数字を、出典と「この数字から言えないこと」を添えて公開するものです。
記録日:2026 年 10 月 22 日。数字はすべて、当社の調査記録(リポジトリの knowledge/claims にある 6 件の主張)に書かれたものだけです。ここで新しく数えたものはありません。他社サイトの名前は出さず、件数だけを載せます。
このページの主張
- AI ボットに対して、サイトは開けるほど良いとは限りません。開けた入口は、AI ボットだけでなく、ほかの誰にとっても開いています。そして開けたことで何が返ってくるかは、サイトごとに違います。
- 良いサイトは、開けるところを開け、閉じるところを閉じています。「閉じる」とは、すべて拒否することではありません。名前を借りただけの相手を見分ける、公開したくないパスを robots.txt に書かない、AI に任せない操作は任せない、ということです。
- 当社が調べた範囲では、「開きすぎ」あるいは「閉じ方が適切」を公式に定義した文書はなく、その釣り合いを点数にして出す診断ツールも見つかっていません(C1)。そのため当社は、軸ごとに、サイトの数字を公式の基準値の隣に並べて見せます。公式の基準がある軸だけ、良し悪しを言います。
このページの言葉
- 当社:migurei(HBLAB の子会社)。Parallel World を運営しています。
- UA:User-Agent。アクセスしてきた側が名乗る名前です。名乗りであって、本人確認ではありません。
- フィード(IP 一覧):OpenAI、Google など各社が公開している、自社ボットの IP アドレスの一覧です。
- 当社が計測している提携サイト:当社がアクセスログを預かっている 1 サイトです。名前は出しません。
- 他社サイト:当社のスキャナー(読み取り専用)で調べた日本のサイトです。名前は出さず、件数だけを書きます。
C1 「開きすぎ」を判定する公式の基準はない
robots.txt、Content Signals、aipref、IP 一覧、逆引き DNS、Web Bot Auth、WebMCP。どれも「どう開けるか、どう閉じるか」の仕組みを与えるだけで、どこまで開けるべきかは、サイトの持ち主が決めることになっています。
数字
- 当社が 2026 年 10 月 22 日に確認した公式文書のうち、サイトが「開きすぎ」「閉じ方が適切」かどうかの基準を定めたものは 0 件でした。
- 確認したのは、RFC 9309、IETF の aipref-vocab(草案 08 版、2026 年 9 月 13 日付、「合意を反映していない」と明記)、Web Bot Auth の草案、Content Signals、Cloudflare の検証済みボット方針(2026 年 10 月 8 日)、OpenAI・Anthropic・Google・Perplexity・Apple のボット解説、文化庁の考え方などです。
- 日本の診断ツールのうち、ミエルカGEO、AKARUMI、LLMOチェキは、閉じ方の評価を公開資料に載せていませんでした。
出典
- RFC 9309、draft-ietf-aipref-vocab、Content Signals、Cloudflare 検証済みボット方針。
- 文化庁「AIと著作権に関する考え方について」(2024 年 3 月 15 日)の 26〜27 ページと注 28、31 は、主要な学習用クローラを robots.txt で拒否していることを、著作権法 30 条の 4 の検討で考慮する要素の 1 つとして挙げています。これは法的な考慮要素の話で、開き方の基準ではありません。
- 主張ファイル:
no-official-verdict-for-too-open.md(確かさ:外部の出典。見つからなかったことが根拠)。
この数字から言えないこと:「見つからなかった」は「存在しない」ではありません。知的財産推進計画 2026、ACP と AP2 の仕様は、直接は読んでいません。Cloudflare の AI Crawl Control のように、Cloudflare 上のサイトでボット別の数字を見せる機能はすでにあります。当社の違いは、Cloudflare を使っていないサイトでも見られる点だけです。
C2 名前は本人確認ではない
UA は名乗りにすぎません。ボットの本人確認になるのは、各社が公開する IP 一覧、逆引き DNS、署名です。名前だけを見て通すサイトは、名前を借りた相手も通します。
数字
- 他社サイト 21 サイト中 18 サイトは、ChatGPT-User、Claude-User、Perplexity-User などを名乗る、各社の IP ではない場所からのリクエストに、当社のスキャナーへの応答と同じように答えました。トップページを UA ごとに 1 回だけ取得した結果です(540 行、90 回のスキャン、2026 年 10 月 3 日〜21 日)。
- 例外は 3 サイトです。2 サイトは ChatGPT-User に 403 を返しました(3 回のスキャンすべて)。1 サイトは MistralAI-User に 403 を返しました(8 回のスキャンすべて)。
- 当社の pw.migurei.ai(2026 年 10 月 1 日〜22 日):Claude-User を名乗る、Anthropic の IP 一覧に載っていない IP からのリクエストが 69 件ありました。うち 68 件は、1 つの IP からの .env と .git の探索で、すべて 404 でした。OpenAI、Google、Bing、Perplexity を名乗るリクエストは、すべて各社の IP 一覧と一致しました。
- 当社の migurei.ai(2026 年 10 月 7 日〜21 日):探索のリクエストが 12,801 件で、2xx は 0 件でした。3,000 件を超える数が、ボット一覧にある名前(約 30 種)を名乗っていました。1 つの IP が、約 2 分のあいだに AI ボット 13 種の名前で 200 件を送り、175 件が 404 でした。
- 当社が計測している提携サイト(2026 年 6 月 19 日〜10 月 2 日):ボットの UA を付けた探索のリクエストが 85,290 件。うち 46,188 件は IP が一覧と一致せず、39,101 件は一覧のない名前で、検証済みのボットからは 1 件でした。
出典
- 当社の ClickHouse
pw.ua_probeとcheck_result(基準internal.fetcher_ua_response)、当社のアクセスログの探索区分と、2026 年 10 月 20 日版のボット登録簿にある IP 一覧。2026 年 10 月 22 日に読み取り。 - 主張ファイル:
sites-answer-fake-ai-ua-like-anyone.md、ai-bot-names-used-to-mask-probes.md(確かさ:当社の観測)。
この数字から言えないこと:本物のフェッチャー(IP を確認済み)が各サイトでどう扱われるかは、この調査では分かりません。CDN が本物の IP は通し、名前だけの相手を止めている可能性があります。トップページを 1 回取得しただけで、再試行もしていません。名前だけの相手に 200 を返したことが、そのサイトに害があったことを意味するわけでもありません。IP が一覧に載らないことは、偽物の証明ではありません(提携サイトは古い一覧を使っており、アクセスログの多くは Cloudflare の中継 IP しか持ちません)。探索のリクエストが 200 を返した 81,151 件も、返ったのはアプリの殻(183〜188 KB)で、ファイルが漏れたことは確認していません。
C3 与えるものと受け取るものの差
当社が計測している提携サイトでは、AI のボットは、そのアプリが人を 1 人送ってくる間に、数十から千以上のページを取得していました。AI ボットに開くことは、今のところ受け取るより与えることのほうが多い取引に見えます。
数字
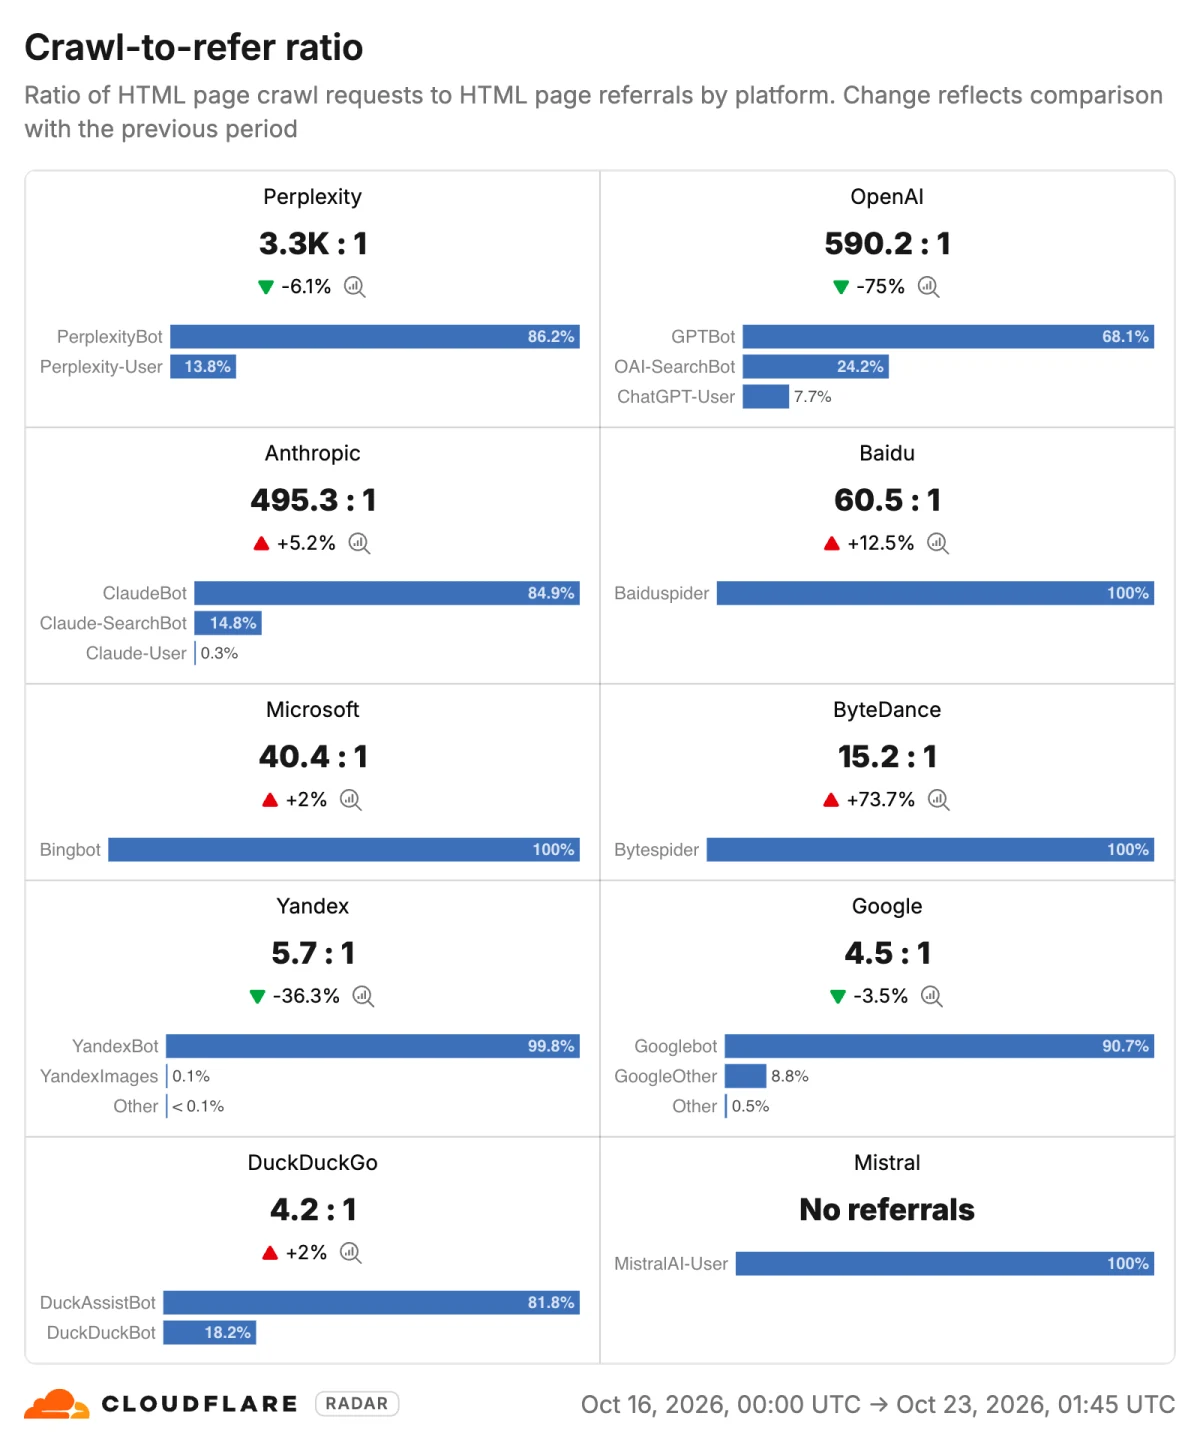
- 世界全体の比較は、Cloudflare Radar をご覧ください。
- 当社が計測している提携サイト(2026 年 6 月 19 日〜10 月 2 日):OpenAI 約 88 対 1、Perplexity 約 407 対 1、Anthropic 約 1,240 対 1。OpenAI は、OAI-SearchBot と ChatGPT-User のリクエスト 317,851 件に対して、ChatGPT を参照元とする人のリクエストが 3,605 件です。
- 当社の pw.migurei.ai と migurei.ai:取得はあるが、AI アプリから来た人は、読み取った期間で 0 件。比は無限大になり、「受け取る側」はまだ測れていません。
出典
- 取得と送客の比の定義:あるプラットフォームのクローラの HTML リクエスト数を、そのプラットフォームからの HTML の参照数で割ったもの(Cloudflare ブログ、2025 年 8 月 28 日)。
- 提携サイトは、当社のボットのアクセスログと、人のリクエストの集計表。
- 主張ファイル:
ai-crawl-to-refer-hundreds-to-one.md(確かさ:提携サイトは当社の観測)。
この数字から言えないこと:参照元を送らないアプリがあるため、比は実際より大きく見えます。学習用のボットは、もともと人の送客を伴いません。ChatGPT-User は 1 つの回答のためにページを取得するもので、人の訪問ではありません。どの比が「妥当」かは、この調査では言いません。また、サイトの持ち主がこの比を変える手段は、実際にはボットを止めることしかなく、止めれば検索や回答への登場が減る可能性があります。
C4 AI を招くファイルは、地図にもなる
robots.txt、sitemap、llms.txt は、AI ボット向けに書いても、誰でも読めます。そこに書いたパスは、公開されたパスです。
数字
- 他社サイト 14 サイトのうち約 10 サイトの robots.txt の Disallow に、/admin があります。多くは Shopify の標準の一覧です。
- 1 サイトは、CMS の内部のパスをいくつか Disallow に載せていました。別の 1 サイトの sitemap には、テスト用の URL が入っていて、400 を返しました。staging のホストを載せた sitemap は、調べた範囲にありませんでした。
- 当社の pw.migurei.ai は、robots.txt に Disallow が 0 件です(設計上、すべて開いています)。
出典
- RFC 9309 の 1 章「These rules are not a form of access authorization」と 3 章「Listing paths in the robots.txt file exposes them publicly and thus makes the paths discoverable」。
- OWASP WSTG-INFO-03(robots.txt、sitemap、.well-known の情報漏えいの確認。llms.txt には触れておらず、「機微なパス」の一覧もありません)。
- 当社のスキャナーが取得した robots.txt の原本(最新の回)。2026 年 10 月 22 日に読み取り。
- 主張ファイル:
robots-disallow-lists-paths-publicly.md(確かさ:原則は外部の出典、件数は当社の観測)。
この数字から言えないこと:パスが robots.txt にあることは、そのパスが開くことを意味しません。当社のスキャナーは禁止されたパスを取得しないので(robots.txt に従います)、開くかどうかは分かりません。当社も、どのパスが「機微」かを点数にはしません。公式の一覧がないためで、パスを並べて見せるだけです。標準の一覧に由来するものが多く、重みは小さいという見方もあります。
C5 エージェントに任せるなら、限りが要る
エージェントが、人に代わってツールを呼んだり買い物をしたりするようになると、問いは「読めるか」から「何をしてよいか」に変わります。必要のないページでは止める、取り消せない操作には印を付ける、という使い方です。
数字
- WebMCP(W3C Community Group Draft Report、2026 年 10 月 20 日付。W3C の標準化トラックではありません)には、ツールの呼び出しを止める
Permissions-Policy: tools=()があります。初期値は自分自身のみ('self')です。 - 現実の世界への影響が大きい、または取り消せない操作には、
consequentialHintを付けて、エージェントに人へ確認させることができます。 - 当社が調べたサイトのうち、WebMCP を有効にしていたものは 0 件でした。当社の pw.migurei.ai も有効にしておらず、MCP サーバー(読み取り専用)は、すでにページにある情報だけを返します。
出典
- WebMCP(Web Machine Learning Community Group):Permissions-Policy の tools 機能、6.4.1 節「Disable access to WebMCP APIs in documents where WebMCP is not an intended capability」、consequentialHint、untrustedContentHint、exposedTo。プロンプトインジェクションは「主にエージェントの責任」とされています。
- 主張ファイル:
webmcp-site-can-turn-tools-off.md(確かさ:外部の出典)。
この数字から言えないこと:この調査の標本にある、WebMCP を有効にしたサイトは 0 件なので、実際の使われ方は分かりません。草案は今後変わります。
Parallel World が測るもの、測らないもの
- 軸ごとに、サイトの数字を、公式の基準値(RFC 9309、WebMCP の草案など)の隣に並べて示します。
- 良し悪しを言うのは、公式の仕様がある軸だけです(robots.txt の書き方、WebMCP のヘッダーなど)。基準のない軸(C1、C3 の「妥当な比」)では、数字を並べるだけで、点数にはしません。
- 当社が独自に決めた採点基準は使いません。公式の API や仕様の結果を、そのまま保存します。
このページ全体として、まだ証明できていないこと
- 件数と期間は限られています。他社サイトは 21 サイト(robots.txt は 14 サイト)、当社が計測している提携サイトは 1 サイト、当社のサイトは 2 サイトです。業界全体の姿ではありません。
- 「閉じる」ほうが良いとは、言っていません。閉じれば、AI の検索や回答への登場が減る可能性があります。そのために当社は、軸ごとに「開けた効果」と「閉じた効果」を別々に測ります。
- 書いているのも、測ったのも当社です。独立した第三者の確認はありません。
公式の出典
- RFC 9309 Robots Exclusion Protocol(IETF、2022 年 9 月)
- Cloudflare Radar:AI クローラのトラフィックを目的と業種で見る(2025 年 8 月 28 日)
- WebMCP(Community Group Draft Report、2026 年 10 月 20 日)
- 文化庁「AIと著作権に関する考え方について」(2024 年 3 月 15 日)
- OWASP Web Security Testing Guide:WSTG-INFO-03
このページが使った主張
knowledge/claims/no-official-verdict-for-too-open.mdknowledge/claims/sites-answer-fake-ai-ua-like-anyone.mdknowledge/claims/ai-bot-names-used-to-mask-probes.mdknowledge/claims/ai-crawl-to-refer-hundreds-to-one.mdknowledge/claims/robots-disallow-lists-paths-publicly.mdknowledge/claims/webmcp-site-can-turn-tools-off.md